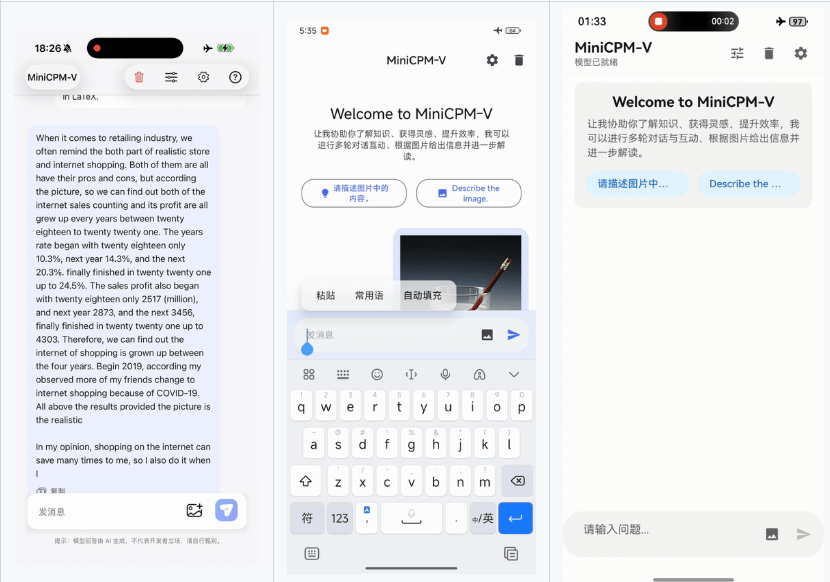
MiniCPM-V 是面向端侧高性能与高效部署的多模态大模型系列,在 iOS、安卓、鸿蒙上实现极致高效的图像与视频理解。MiniCPM-V 专注于图像、视频和文本输入的高效视觉语言理解;MiniCPM-o 进一步扩展到实时端到端全模态交互,支持流式视频和音频输入以及文本和语音输出。
MiniCPM-V 4.6 是这个系列最新、最高效的模型,总参数量仅 1.3B,性能超过更大参数的 Gemma4-E2B-it,同时相比 Qwen3.5-0.8B 有约 1.5 倍左右的 token 吞吐。它基于 LLaVA-UHD 的 ViT 内提前压缩技术,把视觉编码开销降低 50% 以上,支持 4 倍/16 倍混合视觉 token 压缩率,可在精度与速度间灵活切换,并能在三大主流手机平台部署(开源附带端侧适配代码)。
MiniCPM-o 4.5 总参数量 9B,视觉、语音及全双工多模态实时流式交互接近 Gemini 2.5 Flash,能做到”边看、边听、边说”,支持主动提醒等交互。MiniCPM-V 4.6 适配 SGLang、vLLM、llama.cpp、Ollama 等推理框架,支持 SWIFT、LLaMA-Factory 等微调生态,提供 GGUF、BNB、AWQ、GPTQ 多种量化版本权重,消费级显卡即可定制。